> ## Documentation Index
> Fetch the complete documentation index at: https://chatcli.edilsonfreitas.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Task Graph
> Execute um plano multi-task aprovado como um DAG verificado: squad workers paralelos por task, gates de validação executados pelo próprio engine e o veredito de um reviewer independente antes de qualquer coisa contar como done — com dashboard live no browser.
O **Task Graph** transforma um plano aprovado em um DAG persistido executado por [squad workers](/pt/agents/agent-squad) paralelos — com uma regra inegociável: **done nunca é a autodeclaração do executor**.
```text theme={"system"}
plano → task graph → execução paralela → gate do engine → review independente → done | retry
```
Com vários agentes em paralelo, uma task erroneamente autodeclarada como concluída libera as dependentes sobre uma premissa falsa. O task graph torna a verificação estrutural em vez de narrativa: o orquestrador é código Go determinístico (não um LLM), os comandos de validação são executados pelo próprio engine, e o veredito vem de um **reviewer worker de contexto limpo** que nunca compartilha contexto com o executor.
***
## Quando usar
| Situação | Ferramenta certa |
| - | - |
| 1–4 tasks, ou trabalho estritamente serial | Workers via `agent_call` direto ou o [playbook do squad](/pt/agents/agent-squad) |
| **5+ tasks com independência real**, plano aprovado, entregável verificável | **`@taskgraph`** — o paralelismo paga o overhead de orquestração |
A [skill](/pt/tools/builtin-skills) embutida `task-graph` ensina ao modelo essa régua, o schema do plano e a disciplina ("você nunca declara done").
Você não precisa pedir pelo nome. Uma tarefa grande (complexidade ≥ 6) é **auto-roteada** para cá por padrão — ver [Plan-and-Solve → Roteamento para o task graph](/pt/agents/harness/plan-and-solve#roteamento-para-o-task-graph). O roteamento direciona, não força: trabalho genuinamente serial ou pequeno ainda roda direto.
***
## O schema do plano
Um único objeto JSON descreve a entrega inteira:
```json theme={"system"}
{
"name": "feature-x",
"require_review": true,
"phases": [{"id": "F1", "title": "Server"}, {"id": "F2", "title": "Client"}],
"tasks": [
{"id": "T1", "phase": "F1", "title": "Add /foo endpoint", "agent": "coder",
"prompt": "Implement GET /foo in server/handler.go returning ...",
"validation": [{"run": "go test ./server/...", "expect": "all green, includes a /foo case"}]},
{"id": "T2", "phase": "F2", "title": "CLI client", "deps": ["T1"],
"prompt": "Add the /foo client call. Server contract: #T1",
"validation": [{"run": "go build ./...", "expect": "builds clean"}]}
]
}
```
* `deps` só pode referenciar tasks declaradas **antes** (o que também elimina ciclos).
* `prompt` precisa ser autocontido — workers não veem a conversa. `#` é substituído pelo output daquela dependência.
* Os comandos de `validation[].run` são executados pelo **engine** (herdando o [sandbox do coder](/pt/coder/coder-security) e a denylist de comandos perigosos) — nunca pelo executor. `expect` é prosa para o reviewer. Uma string simples vale como contrato só-prosa (o reviewer verifica por inspeção).
* `agent` tem default `coder` (qualquer worker type do squad funciona); `max_attempts` default 3; `require_review` default **true**, por grafo ou por task.
* `tools` opcionalmente concede ao worker **executor** da task plugins da sessão — `"tools": ["@browser", "@websearch"]`. O reviewer nunca os recebe. Ver [Capacidades do worker](#capacidades-do-worker) abaixo.
***
## Execução: ready-set scheduling
Tasks disparam no instante em que suas dependências concluem — sem barreiras de nível, sem wall-clock desperdiçado. A concorrência é limitada pela env já existente do squad, `CHATCLI_AGENT_MAX_WORKERS` (o `max_parallel` do próprio grafo pode reduzi-la); **nenhuma variável de ambiente nova** foi adicionada para essa feature.
Cada task passa por um loop de tentativas:
1. **Checkpoint** — um [snapshot shadow-git](/pt/coder/coder-plugin#checkpoints) do workspace, best-effort, antes do executor começar.
2. **Executor** — um worker fresco recebe o prompt (mais o feedback do reviewer nos retries).
3. **Gate** — o engine executa ele mesmo cada comando de `validation[].run` e grava a saída; exit diferente de zero falha a tentativa sem gastar reviewer.
4. **Review** — um `reviewer` worker fresco (ferramentas read-only) recebe o contrato, as saídas do gate e o relato do executor, e precisa terminar com `VERDICT: PASS — evidência` ou `VERDICT: FAIL — o que falta`.
5. **Promoção ou retry** — gate verde + PASS promove a `done` com a evidência gravada; FAIL repete com o feedback injetado, até `max_attempts`, quando a task falha e suas sucessoras ficam `blocked`.
O engine **recusa**: ciclos de dependência, iniciar task com deps não satisfeitas, promover sem gate + veredito quando o review é exigido, e reviewer = executor (cada um é um dispatch distinto — os dois run IDs ficam gravados na tentativa como prova).
Estados: `pending → running → reviewing → done | failed | blocked`.
Cada tentativa também carrega seu **custo real**: cada chamada LLM de worker é atribuída ao nó do grafo que a originou, com a mesma contabilidade por chamada do [cost tracking](/pt/providers/cost-tracking).
***
## Superfícies
### `@taskgraph` (para a IA)
```json theme={"system"}
{"cmd":"run","args":{"file":"/tmp/plan.json"}} // executa um plano de arquivo (RECOMENDADO)
{"cmd":"run","args":{"graph":{...}}} // planeja + executa inline (só grafos pequenos)
{"cmd":"run","args":{"id":"tg-..."}} // executa/retoma um plano persistido
{"cmd":"plan","args":{"file":"..."}} // valida + persiste apenas (arquivo ou grafo inline)
{"cmd":"status"} // status por task, tentativas, vereditos, custo
{"cmd":"show","args":{"task":"T3"}} // uma task completa: saídas do gate, evidência, run ids
{"cmd":"retry","args":{"task":"T3"}} // reabre uma task falha (+1 tentativa) e retoma
{"cmd":"cancel"} // para a run ativa
{"cmd":"list"} // runs persistidas
{"cmd":"dash"} // serve a dashboard live, retorna a URL
{"cmd":"prune","args":{"older_than":"7d"}} // remove runs antigas ("all" mantém só a ativa)
```
**Arquivo primeiro para grafos reais.** Args `graph` inline acima de \~2KB são truncados pelo limite de tokens de output ("unexpected end of JSON input"). A forma confiável são duas chamadas: escreva o JSON do plano com `@coder write` e rode com `file` — o arquivo pode conter o plano cru, `{"graph":{...}}` ou o envelope completo. A skill embutida ensina exatamente isso ao modelo.
`run` executa o grafo inteiro em uma única tool call, streamando eventos conforme acontecem. Resume é inerente: tasks concluídas ficam done, então re-executar um grafo que falhou continua de onde parou.
### `/taskgraph` (para humanos)
```bash theme={"system"}
/taskgraph status [id] # status por task, vereditos, custo
/taskgraph show T3 [id] # uma task: tentativas, saídas do gate, evidência
/taskgraph list # runs persistidas
/taskgraph dash [id] # abre a dashboard live no browser
/taskgraph prune [7d|all] # remove runs antigas (default 30d; a run ativa nunca é removida)
/taskgraph cancel # para a run ativa
```
`/taskgraph` é permitido como **side command mid-run** — digite enquanto o grafo executa para inspecionar o progresso sem tocar no loop do orquestrador.
***
## A dashboard live
Esta dashboard vai a fundo em **um run de task graph**. Para acompanhar o runtime inteiro ao vivo (cada agent, requisição de LLM, tool, skill, servidor MCP, padrão e job em background, entre processos), use [`/dash`](/pt/usage/live-dashboard); os runs de task graph também aparecem lá.
`/taskgraph dash` (ou `{"cmd":"dash"}`) serve uma dashboard no browser a partir de uma porta efêmera em `127.0.0.1` — um único arquivo embarcado, zero CDN, zero configuração:
* **Canvas de DAG animado** — swimlanes por fase, béziers de dependência com traços animados nas tasks em execução, cards coloridos por status com contagem de tentativas e custo por task; arraste para pan, ctrl/⌘+scroll para zoom, `0` para ajustar, highlight de linhagem no hover.
* **Popovers de evidência** — clique numa task para ver prompt, contrato de validação, saídas do gate, veredito + evidência do reviewer e os run IDs de executor e reviewer.
* **Aba Results** — critical path, wall-clock vs tempo de agente, fator de paralelismo e o custo real por task.
* **Live** — a página consulta o estado persistido a cada segundo e acompanha o feed de eventos.
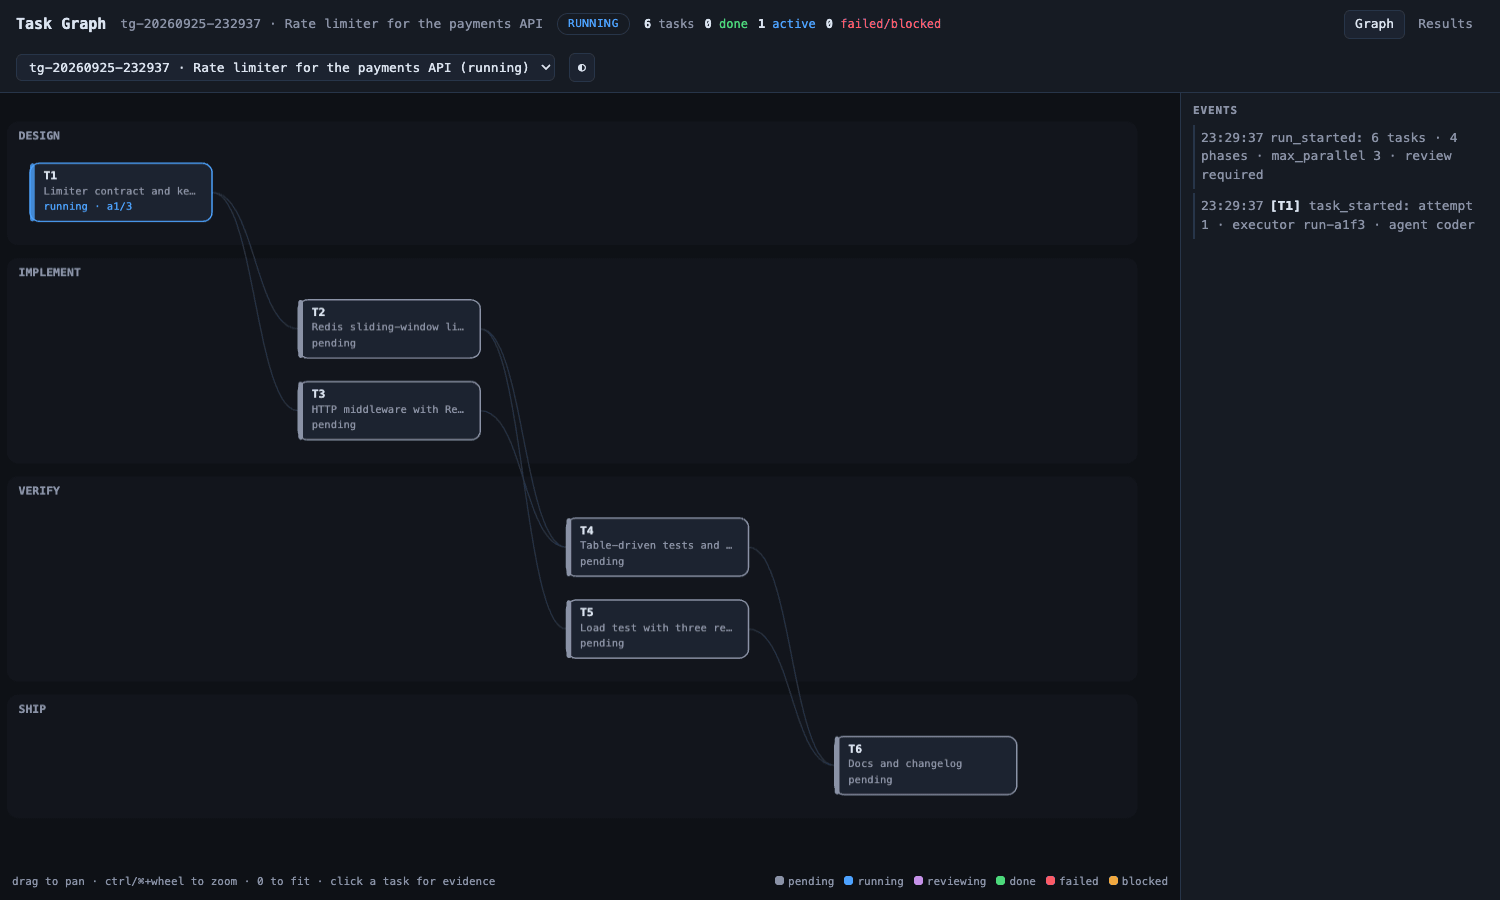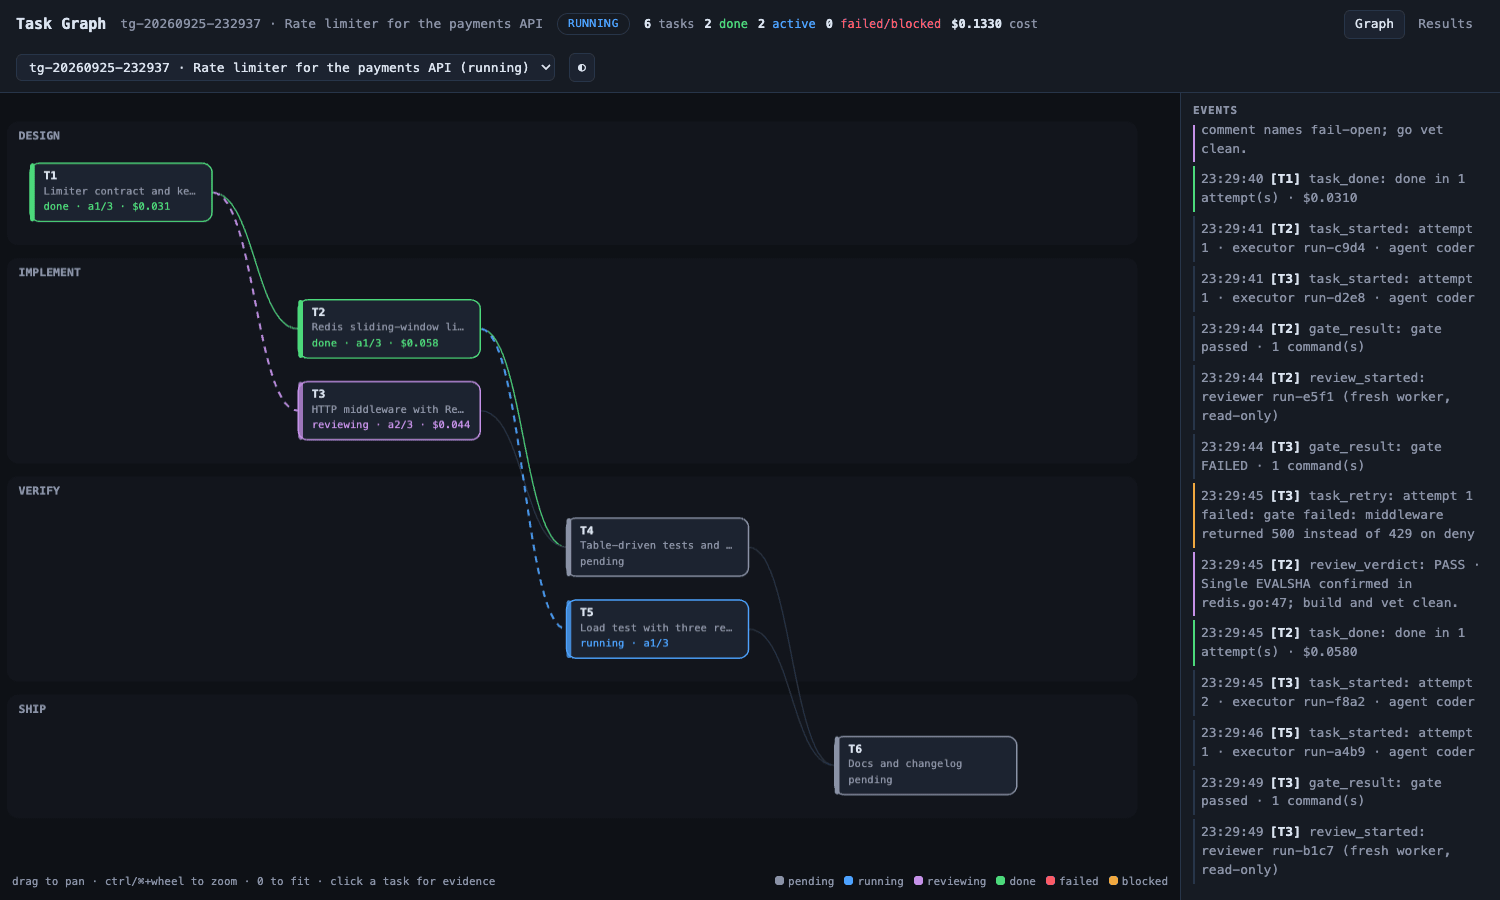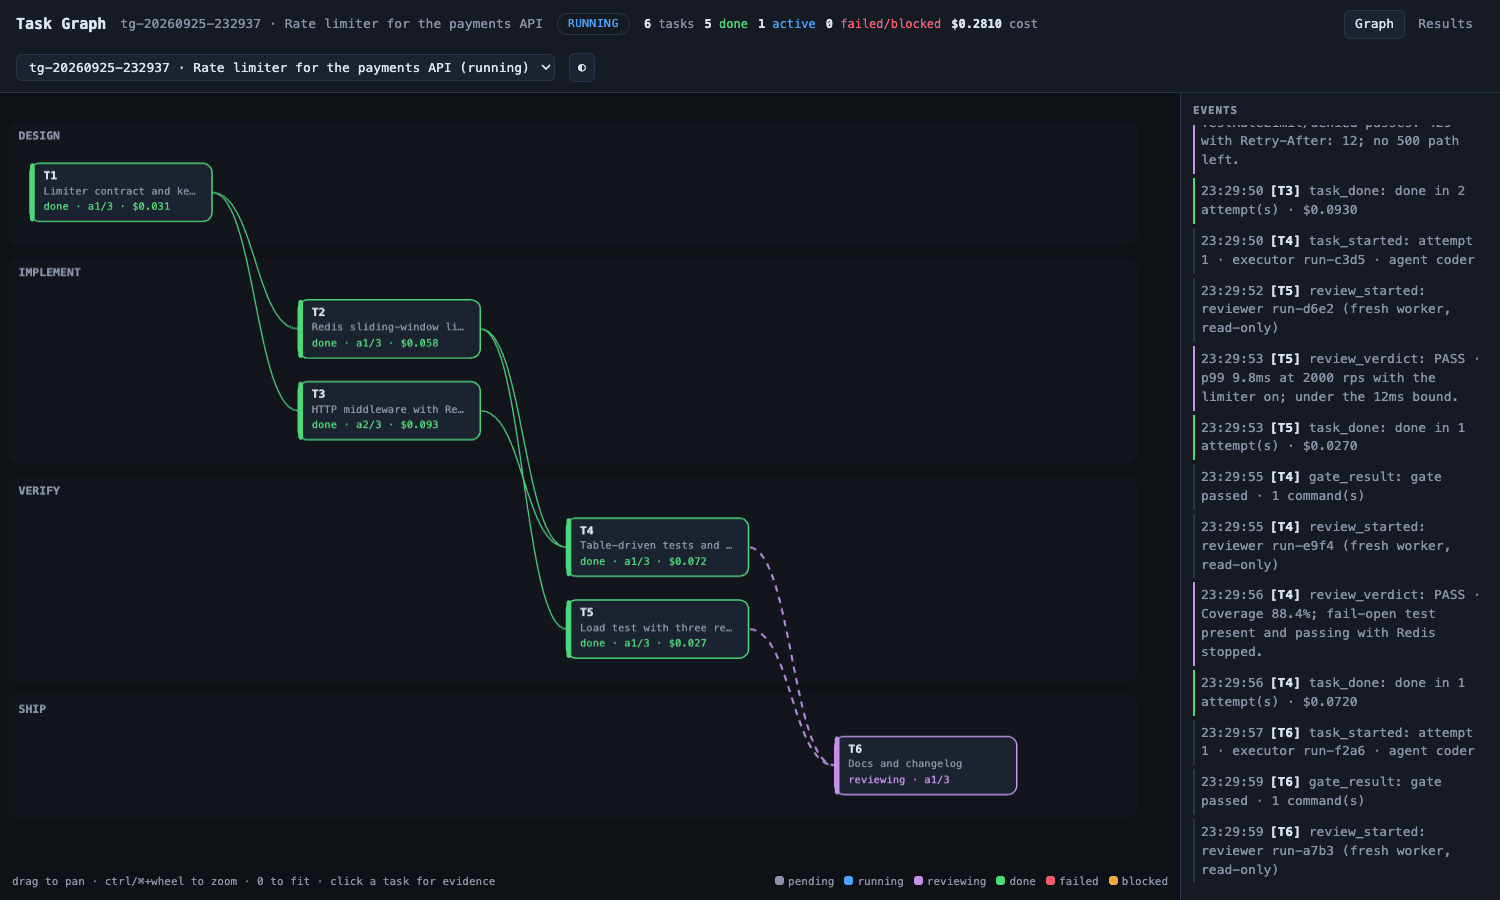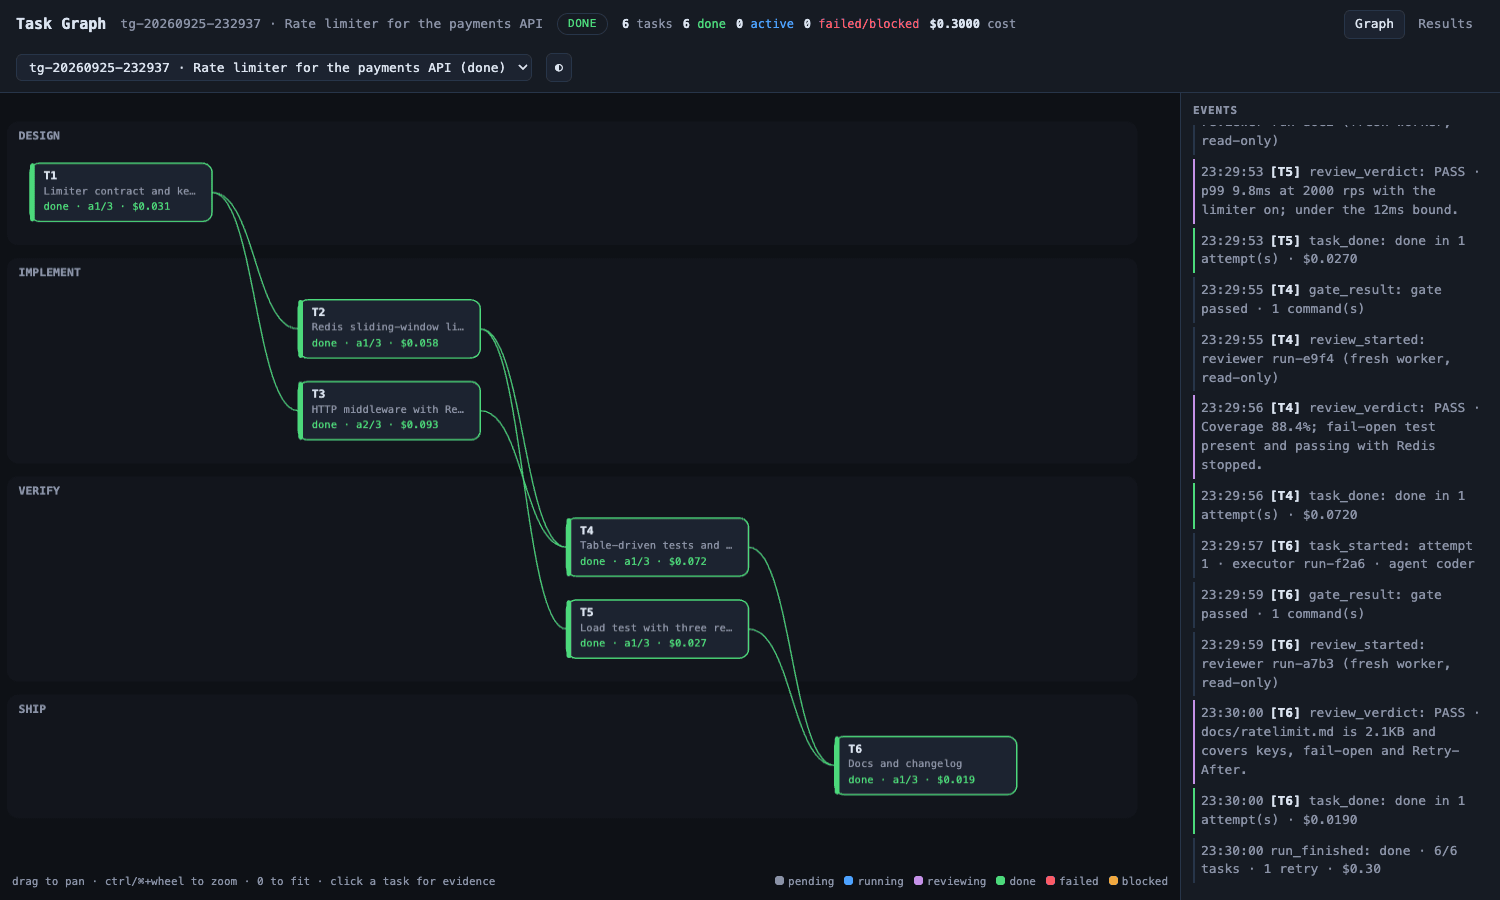 O servidor é **estritamente read-only**: lê `state.json` e `events.ndjson` do disco a cada request. Fechar a dashboard nunca afeta uma run, e runs finalizadas renderizam igualmente bem.
***
## Capacidades do worker
Cada executor e reviewer roda com o contexto da própria sessão — recall proativo de memória/sessão, expansão CCR de resultados truncados e tools read-only de memória/sessão/knowledge — então o worker aproveita o que a sessão já aprendeu em vez de começar às cegas.
Além disso, duas capacidades são opt-in por task:
* **Concessão de tools.** `"tools": ["@browser", "@websearch"]` numa task dá ao **executor** dela esses plugins da sessão (builtins ou `mcp_*`), gateados pela mesma política de segurança — um `@browser click` pede aprovação como pediria no `/coder`. O reviewer nunca recebe tools (a função dele é inspeção). O `@browser` dirige uma única página compartilhada, então conceda-o a **uma** task por vez; tasks de browser em paralelo corromperiam as refs de elemento uma da outra.
* **Skills do usuário.** O texto da task é casado contra as suas [skills](/pt/tools/builtin-skills) do mesmo jeito que o orquestrador faz: skills pinadas sempre valem, as trigger-matched são injetadas (com cap e budget). Seu conhecimento curado chega a cada executor.
Ao fim de uma run, um **learning digest** compacto alimenta a memória de longo prazo da sessão (facts, episódios, candidatos a skills auto-evolutivas) e uma lesson de Reflexion é enfileirada por task falhada — o grafo ensina a sessão, não só entrega.
***
## Persistência
Cada run possui `~/.chatcli/taskgraph//`:
| Arquivo | Papel |
| - | - |
| `state.json` | O grafo completo, escrito atomicamente a cada transição (arquivos corrompidos são quarentenados, nunca sobrescritos) |
| `events.ndjson` | Trilha de auditoria append-only — também o feed da dashboard |
O store é **limitado**: runs com mais de 30 dias são removidas automaticamente no primeiro acesso ao store da sessão (idade = última escrita de estado), e o `prune` limpa sob demanda — durações Go (`72h`), sufixo de dias (`30d`) ou `all`. A run ativa nunca é removida.
As runs aparecem em `/agents` (e no [Conversation Hub](/pt/gateway/conversation-hub)) como uma run-mãe com cada executor e reviewer registrados como filhos — o cancelamento propaga pela árvore.
O task graph foi inspirado na disciplina executor ≠ reviewer das skills de orquestração em grafo: autodeclaração não é veredito. No ChatCLI o orquestrador é código determinístico nativo, então o grafo, os gates e a promoção a done ficam estruturalmente fora do alcance de alucinação do modelo.
This documentation is built and hosted on [Mintlify](https://mintlify.com), a developer documentation platform.